Symfony Scheduler i Messenger: wyniesienie pracy cyklicznej poza requesty HTTP
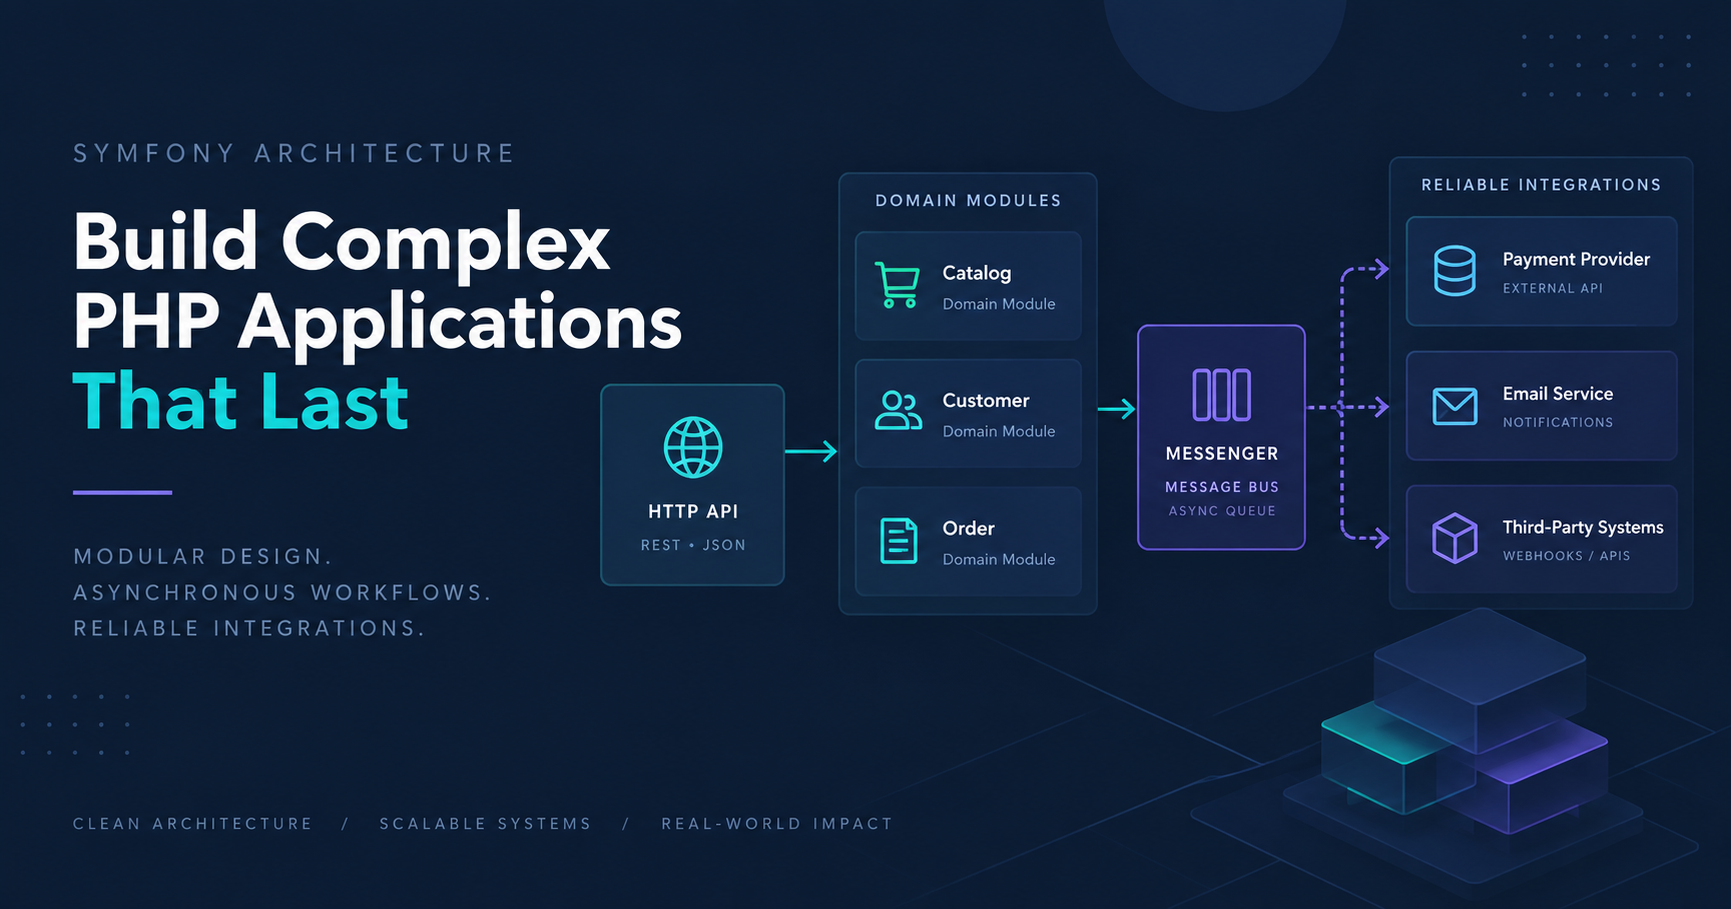
Aplikacja, która okresowo agreguje dane, ma dwóch różnych konsumentów: zegar, który powinien uruchamiać pracę, i czytelnika, który później pyta o wynik. Połączenie obu w jeden request HTTP utrudnia interpretację awarii. Czy zawiódł request, zewnętrzny provider, czy obliczenie w ogóle nie zostało uruchomione? Rozdzielenie wyzwalacza, obliczenia, persystencji i odczytu czyni każdą odpowiedź widoczną.
Ten artykuł opisuje takie rozdzielenie standardowymi komponentami Symfony — Scheduler, Messenger, HttpClient i Doctrine — na celowo ogólnym przykładzie: godzinnej migawce zewnętrznych danych rynkowych, której zapisana historia jest serwowana przez API. Przykład jest ilustracyjny, a nie opisem konkretnego systemu produkcyjnego. Nazwy klas dobrano tak, by pokazać odpowiedzialność, a nie do kopiowania.
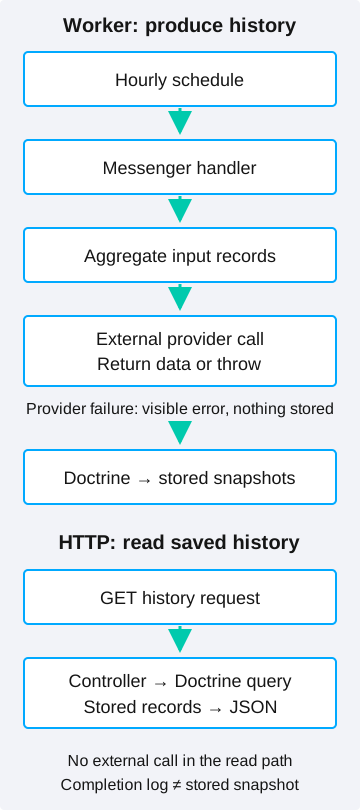
Konkretny efekt polega na tym, że odczyt zapisanej historii nie uruchamia nowego obliczenia. Zaplanowany handler zapisuje wyniki; kontroler HTTP je odczytuje. Dostępność providera staje się wtedy własnością ścieżki zapisu, a nie każdego wyświetlenia strony.
Najpierw sprawdź założenia wersji
Symfony publikuje nowe wersje minor dwa razy w roku, a każde wydanie ma określone okno wsparcia. Zanim skopiujesz przykład — w tym ten — sprawdź stronę wydań Symfony pod kątem utrzymywanej wersji i czytaj dokumentację jej odpowiadającą. Atrybuty, nazwy transportów i wartości domyślne zmieniają się między wydaniami.
Ograniczenie wersji w composer.json to deklaracja, a nie dowód na to, co jest zainstalowane lub uruchomione. Zweryfikuj lock file i wdrożone pakiety. Podobnie zadanie cykliczne zdefiniowane w kodzie nie wykonuje się samo: ktoś musi konsumować harmonogram, o czym mowa w następnej sekcji.
Porównaj cron, Scheduler i pracę w trakcie requestu
Systemowy cron wywołujący komendę konsoli Symfony to rozsądny wybór dla jednego krótkiego, stałego zadania okresowego. Nie wymaga długo działającego konsumenta. Jego granice są operacyjne: harmonogram żyje poza dependency injection aplikacji, a każdy deployment musi utrzymywać zewnętrzny crontab zgodny z wydaniem.
Symfony Scheduler definiuje powtarzalne wiadomości w kodzie aplikacji, więc harmonogram jest wersjonowany obok handlera i jego zależności. Kompromis polega na tym, że konsument Messengera musi działać, restartować się po deployach i być monitorowany. Zdefiniowanie harmonogramu produkuje wiadomości; nie tworzy workera. W wdrożeniu kontenerowym konsument to zwykle osobny proces lub replika z własną polityką restartów — o jedną rzecz więcej do poprawnego skonfigurowania niż wpis w crontab.
Obliczanie w trakcie requestu HTTP to najprostszy wyzwalacz, ale wiąże czas odpowiedzi i powodzenie z zewnętrznym providerem. Może pasować do jawnego odświeżania na żądanie z jasnym timeoutem. To kiepskie domyślne rozwiązanie dla endpointu historii, którego zadaniem jest zwracanie już istniejących rekordów.
Śledź zaplanowaną wiadomość
W ogólnym przykładzie provider deklaruje godzinną wiadomość. To minimalny, ale kompletny wzorzec z dokumentacji Scheduler:
#[AsSchedule('default')]
final class SnapshotScheduleProvider implements ScheduleProviderInterface
{
    public function getSchedule(): Schedule
    {
        return (new Schedule())->add(
            RecurringMessage::cron('0 * * * *', new StoreSnapshot()),
        );
    }
}
Wyrażenie cron emituje StoreSnapshot na początku każdej godziny do transportu scheduler_default. Opcje takie jak stateful() i processOnlyLastMissedRun() sterują odtwarzaniem po przestoju konsumenta: decydują, czy pominięte uruchomienia są odtwarzane, a nie czy utracone dane da się zrekonstruować. Migawka wykonana później nadal używa danych dostępnych w chwili przetwarzania.
Handler jest rejestrowany przez #[AsMessageHandler] i deleguje do serwisu aplikacyjnego. Delegacja ma znaczenie: handler powinien koordynować, a pobieranie, agregacja i zapis żyją w testowalnych współpracownikach. Wpis w logu o zakończeniu dowodzi jedynie, że delegowane wywołanie powróciło — dlatego ścieżka błędu zasługuje na osobną sekcję.
Uczyń awarię widoczną
Najistotniejsza decyzja projektowa to to, co handler robi, gdy zewnętrzny provider zawodzi. Zwrócenie null z zalogowaniem błędu wygląda ostrożnie, ale zamienia awarię w zwykłą wartość zwracaną. Automatyczny retry Messengera reaguje na wyjątki, a nie na wartości, więc połknięty błąd nie może być ponowiony, a log zakończenia może ukryć pusty wynik.
Rzucenie wyjątku czyni awarię jawną. Dokumentacja Messengera opisuje domyślną politykę retry i opcjonalny failure transport, który zapisuje nieudane wiadomości do późniejszego przeglądu komendami messenger:failed:*. Failure transport wymaga własnego magazynu — zwykle transportu Doctrine z tabelą — więc to świadoma decyzja wdrożeniowa, a nie darmowa funkcja.
Retry są ograniczone, a idempotencja nadal ma znaczenie. Ponownie uruchomione zadanie migawki powinno być naturalnie powtarzalne — „zapisz bieżącą godzinę" jest idempotentne, gdy okres stanowi klucz unikalny — albo sprawdzać przed zapisem. Dla powtarzalnych wiadomości schedulera kolejny tick sam jest retry, co jest prostszym modelem odtwarzania niż odtwarzanie kolejki.
Szanuj precyzję na granicy
Jeśli zapisywana wartość to pieniądze lub wielkość mierzona, arytmetyka musi odpowiadać kolumnie. Kolumna decimal(18,8) przechowuje dokładne wartości dziesiętne; mnożenie ilości i cen jako PHP float wprowadza binarne zaokrąglenia, zanim wartość dotrze do bazy. Późniejsza konwersja float na string nie odzyskuje utraconych cyfr.
Praktyczna poprawka jest niewielka: trzymaj ilości i ceny jako stringi dziesiętne, licz rozszerzeniem BCMath i zaokrąglaj raz — na granicy persystencji — do skali kolumny. Serializuj zapisany decimal jako string w odpowiedzi API, aby osiem cyfr ułamkowych przetrwało JSON. To, czy wykres konwertuje go przez Number(), jest decyzją prezentacji.
Utrzymuj granicę HTTP uczciwą
Po stronie odczytu kontroler powinien jedynie odpytywać zapisane wiersze. Parametry query nadal wymagają jawnej walidacji: ograniczona liczba całkowita dla filtra „ostatnie N godzin", daty ISO 8601 dla zakresu, sprawdzenie, że początek zakresu poprzedza koniec, oraz maksymalna liczba wyników, aby request bez filtrów nie mógł przesłać całej tabeli. Nieprawidłowe dane powinny dawać błąd klienta, a nie nieprzechwycony wyjątek.
Timestampy zasługują na taką samą uwagę. Jeśli API dodaje do sformatowanego czasu sufiks Z, wartość musi faktycznie być w UTC — samo formatowanie jej nie konwertuje. Ustaw strefę czasową jawnie albo zapisuj UTC przy zapisie, a potem udokumentuj kontrakt. Ta sama dyscyplina dotyczy uwierzytelniania: definicja route nic nie mówi o tym, kto może ją wywołać, więc reguły dostępu należą do konfiguracji bezpieczeństwa i checklisty review.
Testuj z fake'ami, nie z siecią
Każdą granicę można testować bez wywołań zewnętrznych. MockHttpClient z dokumentacji HttpClient zwraca z góry zapisane odpowiedzi, więc testy mogą pokrywać poprawną cenę, zniekształcony payload i niedostępność providera. Zamockowany entity manager albo izolowany schemat SQLite weryfikują, że nieudane wycenienie niczego nie zapisuje, a wejście dziesiętne przetrwa do ośmiu miejsc.
Takie pokrycie jest cenniejsze niż test end-to-end na żywym providerze, który nie jest ani deterministyczny, ani bezpieczny jako zależność w CI. Asercje powinny celować w kontrakt: dokładny zapisany string, wyjątek przy awarii, odrzucone parametry query.
Praktyczny wniosek i granice
Lekcja architektoniczna to rozdzielenie wyzwalania, obliczania, dostępu do providera, persystencji i odczytu oraz uczynienie awarii jawnym wynikiem, a nie detalem w logu. Nic z tego nie wymaga mikroserwisów — modularny monolit z jasnymi granicami daje tę samą korzyść.
Nie wdrażaj tej machinerii domyślnie. Jedno krótkie zadanie może zostać na cronie; prosta strona z treścią nie potrzebuje nic z tego. A gdy wynik jest finansowy, traktuj precyzję, retry i kontrolę dostępu jako wymagania do wyspecyfikowania, a nie zachowanie do założenia. Po pomoc w ograniczonej implementacji zobacz development w Symfony.
Laravel multi-tenant SaaS: routing domen i izolacja PostgreSQL w VetSpace
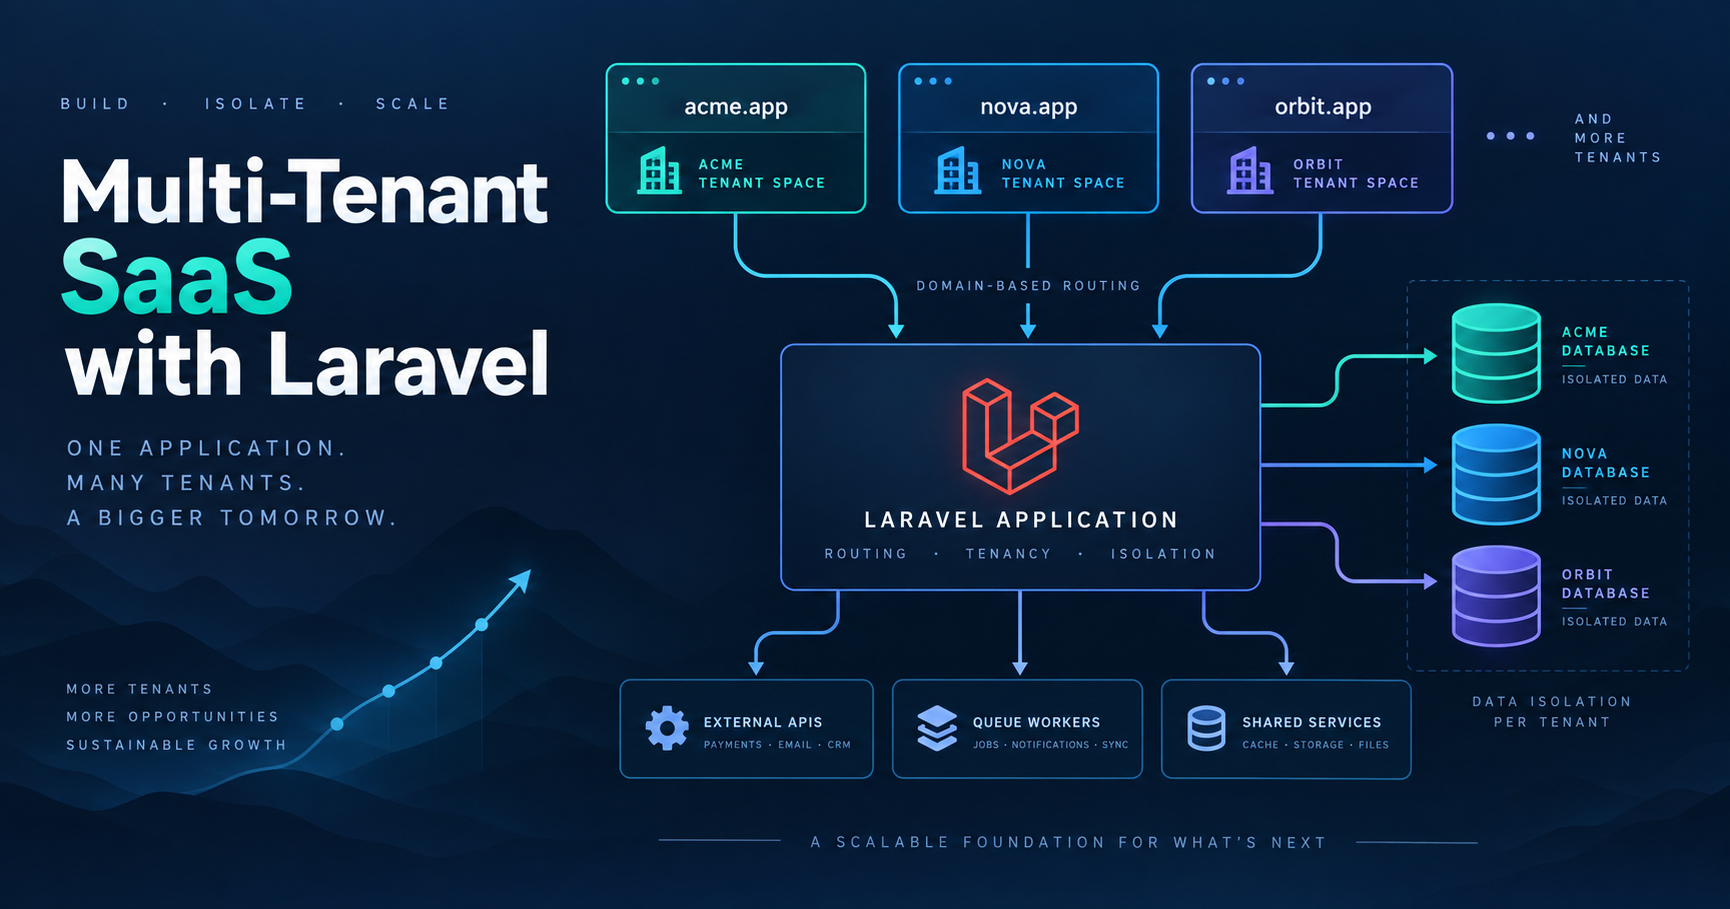
Platforma dla klinik musi odpowiedzieć na dwa pytania przed odczytaniem karty pacjenta: do której organizacji należy request i do jakich rekordów może mieć dostęp ten użytkownik? Nazwa domeny pomaga odpowiedzieć na pierwsze. Nie odpowiada na drugie i sama nie utrzymuje workera w tle w prawidłowym kontekście bazy danych.
Ten artykuł analizuje te granice w API Laravel VetSpace. To analiza kodu źródłowego identyfikacji tenanta, wyboru magazynu PostgreSQL, provisioningu i analizy w kolejce. Nie jest to twierdzenie, że niezależna ocena bezpieczeństwa wykazała pełną izolację, ani że projekt osiągnął zmierzony wynik komercyjny.
Użyteczny wynik to powtarzalna granica organizacji bez osobnej bazy kodu dla każdej kliniki. Rozwiązanie domeny wybiera kontekst kliniki, provisioning tworzy jej magazyn i początkowe rekordy, a jawne sprzątanie zapobiega pozostawieniu tego kontekstu aktywnego przez zadanie w kolejce. Współdzielone centralne rekordy nadal wymagają własnych kontroli autoryzacji.
Porównaj modele przechowywania przed wyborem
W projekcie ze wspólną tabelą wiersze niosą identyfikator organizacji. Istnieje jeden schemat do migracji, a raportowanie między organizacjami jest proste. Koszt to wszechobecny wymóg ograniczania: każde zapytanie, relacja, eksport i zadanie w tle musi wymuszać prawidłową granicę organizacji. Polityki bazy danych mogą dodać ochronę, ale wymagają starannego projektu uprawnień i kontekstu połączenia.
Projekt schema-per-tenant daje każdej organizacji własne tabele w jednej bazie PostgreSQL. Pozwala to uniknąć kolizji między identycznie nazwanymi tabelami i wspiera migracje specyficzne dla tenanta. Nie tworzy to osobnego serwera ani absolutnej bariery dostępu. Dokumentacja schematów PostgreSQL wprost wyjaśnia, że uprawnienia decydują o dostępie między schematami, a search_path wpływa na rozwiązywanie nazw.
Projekt database-per-tenant oddziela cele połączeń i może ułatwić definiowanie procedur backupu i odtwarzania dla poszczególnych klientów. Zwiększa też pracę operacyjną: migracje, monitoring, zarządzanie połączeniami i odtwarzanie muszą pokrywać wiele baz. Bazy na tym samym klastrze nadal współdzielą infrastrukturę. Żaden z tych wyborów sam w sobie nie stanowi gwarancji zgodności regulacyjnej.
Co VetSpace faktycznie implementuje
VetSpace używa stancl/tenancy i modelu Tenant implementującego TenantWithDatabase, z concerns pakietu HasDatabase i HasDomains. Pakiet obsługuje menedżery zarówno baz danych, jak i schematów PostgreSQL, jak opisano w jego dokumentacji multi-database. Własny menedżer aplikacji decyduje, którego użyć.
Istotny szczegół polega na tym, że decyzja nie jest po prostu „enterprise oznacza bazę, wszystko inne — schemat". Istniejący magazyn ma pierwszeństwo. To wyrażenie jest fragmentem UserRolePostgreSQLManager::resolveManager(); zależy od kontroli istnienia w tej klasie i importowanych klas menedżerów, więc nie jest samodzielnym skryptem provisioningu:
$managerClass = match (true) {
    $this->existsAsDatabase($name) => PostgreSQLDatabaseManager::class,
    $this->existsAsSchema($name) => PostgreSQLSchemaManager::class,
    $plan === 'enterprise' => PostgreSQLDatabaseManager::class,
    default => PostgreSQLSchemaManager::class,
};
Menedżer sprawdza katalog baz danych PostgreSQL i metadane schematów przez centralne połączenie. Dopiero gdy nie istnieje żadna forma magazynu, plan wybiera początkowy układ. To zachowuje starszych tenantów utworzonych z własną bazą, nawet jeśli ich obecny plan nie jest już enterprise. Zmiana planu nie migruje ich danych. Każde przeniesienie magazynu wymaga osobno zaprojektowanej procedury kopiowania, walidacji i przełączenia.
Oddziel centralne i kliniczne API
Repozytorium ma centralne route'y i route'y domen tenantów. Operacje centralne obejmują współdzielone rekordy właścicieli i zwierząt oraz rejestr tenantów. Operacje kliniczne obejmują filie, wizyty i terminy. To różne odpowiedzialności za dane w jednej aplikacji, a nie dowód niezależnie wdrożonych usług.
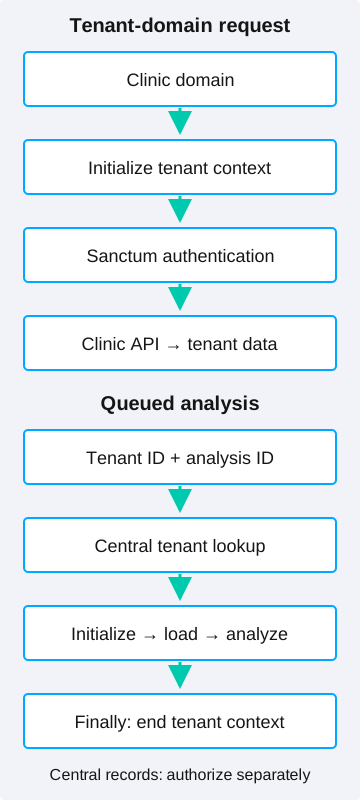
Na route'ach tenanta zapisana tablica middleware nie jest całą historią wykonania. TenancyServiceProvider dodaje middleware tenancy na początek listy priorytetów middleware Laravela. Inicjalizacja domeny wykonuje się więc przed uwierzytelnianiem nawet tam, gdzie auth:sanctum pojawia się wcześniej w deklaracji route'a. Wyszukiwanie tokena musi odbywać się przez zamierzone połączenie; przestawienie tablicy route'ów bez sprawdzenia priorytetu wykonania może dać mylącą poprawkę.
Użyteczna weryfikacja używa prawdziwego hostname'a tenanta, inicjalizuje oczekiwany magazyn i uwierzytelnia tokenem utworzonym w tym kontekście. Potem powtórz request wobec domeny innego tenanta i sprawdź odmowę. Sprawdzenie tylko istnienia domeny nie testuje granicy uwierzytelniania, a sprawdzenie tylko ścieżki pozytywnej pomija przypadkowy dostęp do rekordów innej organizacji.
Provisioning to workflow, a nie jeden insert
Provider rejestruje pipeline TenantCreated: utwórz magazyn, zmigruj go, zasil danymi początkowymi, utwórz główną filię i zreplikuj właściciela. Kod ustawia shouldBeQueued(false), więc ten pipeline jest synchroniczny. Opisywanie go jako asynchronicznego onboardingu przeczyłoby implementacji.
Kolejność odzwierciedla prawdziwe zależności: tabele muszą istnieć przed ich danymi początkowymi, a początkowe rekordy kliniki — zanim klinika będzie używalna. Wprowadza to też przypadki częściowej awarii. Jeśli późniejszy krok zawiedzie, wiersz rejestru lub obiekt magazynu mogą już istnieć. Nie można zakładać, że transakcja w jednym połączeniu cofa każdą operację provisioningu między bazami.
Dla eksploatacji produkcyjnej wymagałbym udokumentowanego stanu gotowości i procedury odtwarzania, z testami awarii po każdym istotnym kroku. To rekomendacje, a nie twierdzenie, że sprawdzony pipeline implementuje kompletny system kompensacji. Praktyczna korzyść biznesowa wynika z wiedzy, czy klinika jest gotowa, a nie z traktowania częściowo ukończonej konfiguracji jako udanej rejestracji klienta.
Zadanie w kolejce musi ustalić własny kontekst
RunAiAnalysis niesie dwa identyfikatory: tenanta i analizy. Nie zakłada, że worker odziedziczył request przeglądarki. Handler wyszukuje tenanta w kontekście centralnym, wraca, gdy go nie ma, inicjalizuje tenancy, a potem wyszukuje analizę. Fragment podstawowego przetwarzania i sprzątania:
try {
    tenancy()->initialize($tenant);

    $analysis = AiAnalysis::find($this->analysisId);

    if (! $analysis) {
        return;
    }

    $service->analyze($analysis);
} finally {
    if (tenancy()->initialized) {
        tenancy()->end();
    }
}
To fragment ciała metody prawdziwego zadania, a nie kompletna klasa. Wcześniejsze wyszukiwanie tenanta i wstrzykiwanie zależności pozostają niezbędne. Blok finally wykonuje się, gdy przetwarzanie wraca lub rzuca wyjątek, zapobiegając pozostawieniu przez zadanie kontekstu tenanta aktywnego dla kolejnej pracy. To szczególnie ważne w ponownie używanym procesie workera.
Nie ustala to przetwarzania exactly-once, automatycznego odtwarzania providera ani właściwej polityki retry. Te zależą od konfiguracji kolejki i serwisu analizy. Brak tenanta lub analizy obecnie powoduje wczesny return; czy powinno to też zapisywać zdarzenie operacyjne, to osobna decyzja produktowa.
Centralne rekordy też potrzebują autoryzacji
Izolacja magazynu chroni tylko rekordy zapisane wewnątrz wybranego kontekstu tenanta. VetSpace ma też centralne rekordy właścicieli i zwierząt powiązane z klinikami. Trait ScopesToClinic ogranicza zapytania przez asocjacje clinic_owner i clinic_pet. Pusta lista klinik jest zmuszana do braku dopasowania, a nie zdejmowania ograniczenia.
To rozróżnienie ma znaczenie: centralny rekord może być przechowywany globalnie, lecz widoczny tylko przez autoryzowaną relację z kliniką. Review musi sprawdzić, które kontrolery używają mechanizmu ograniczania, jak wybierana jest uwierzytelniona klinika i jak autoryzowane są zapisy. Istnienie traita nie dowodzi, że każdy endpoint używa go poprawnie.
Co weryfikować i kiedy tego nie kopiować
Przed przyjęciem projektu przetestuj uwierzytelnianie domeny tenanta, odczyty i zapisy między klinikami, ponownie używanego workera obsługującego dwóch tenantów, częściową awarię provisioningu i odtwarzanie jednego tenanta z backupu. Ćwicz zarówno tenantów schema-backed, jak i database-backed. Test pokrywający tylko początkowy wybór planu ominie ważną gałąź istniejącego magazynu.
Efekt biznesowy wspierany przez kod jest strukturalny: jedna aplikacja może kierować pracę do odrębnych kontekstów klinik i ponownie używać zdefiniowanej sekwencji provisioningu. Nie przedstawiono tu zmierzonego zmniejszenia incydentów, godzin wsparcia ani czasu onboardingu. Takie twierdzenia wymagałyby rejestrów operacyjnych i zdefiniowanej linii bazowej.
Dla wewnętrznej aplikacji jednej organizacji ta machineria może być zbędna. Dla małego SaaS z prostą autoryzacją i raportowaniem współdzielone tabele mogą być łatwiejsze w eksploatacji. Dla silniejszej izolacji infrastrukturalnej różne bazy na jednym serwerze mogą wciąż być niewystarczające. Zacznij od wymagań własności, odtwarzania i dostępu, a potem wybierz najprostszy model, który je spełnia.
Po zakres implementacji, a nie szczegóły architektury, zobacz development w Laravel. Pierwsza użyteczna rozmowa dotyczy granicy danych i przypadków awarii, a nie liczby tenantów, którą diagram wydaje się obsługiwać.
Stopniowa modernizacja aplikacji PHP: testy, treści i wydania w DigiSpace
Aktualizacja PHP jest udana tylko wtedy, gdy aplikacja nadal wykonuje pracę, od której zależą jej użytkownicy. Zielona instalacja zależności nie dowodzi, że wyszukiwanie znajduje właściwe rekordy, przetłumaczona strona zachowuje swój adres albo przesłany obraz przetrwa kolejne wydanie. Modernizacja zaczyna się więc od obserwowalnego zachowania i ograniczeń operacyjnych, a nie od wymiany frameworka.
DigiSpace daje konkretny przykład: aplikacja Laravel z publiczną stroną na Blade, zlokalizowaną treścią w bazie danych i panelem administracyjnym Filament. Repozytorium zachowuje też zależności Inertia i Vue. Nie oznacza to, że każdy ekran administracyjny używa tego samego stacku. Dokładna ocena śledzi faktycznie używane route'y i widoki zamiast traktować listę zależności jako kompletną mapę architektury.
Zamierzony wynik biznesowy to sekwencja zmian, które można weryfikować niezależnie. Test regresji wyszukiwania chroni zachowanie katalogu; aktualizacja treści zachowuje pola redakcyjne, których nie jest właścicielem; a kontrola wdrożenia weryfikuje wynikową stronę i zasób. Te mechanizmy czynią zmianę możliwą do recenzji, ale nie dowodzą, że każde wydanie jest odwracalne.
Ustal linię bazową wersji i integracji
Sprawdzony manifest DigiSpace wymaga PHP ^8.3, Laravel ^13.0 i PHPUnit ^11.0. To ograniczenia zależności, a nie stwierdzenie, że każde środowisko działa na identycznej wersji patch. Przed aktualizacją zapisz zainstalowane pakiety, runtime PHP, rozszerzenia, silnik bazy danych i konfigurację workerów na faktycznym celu.
Zinwentaryzuj też zewnętrzne granice aplikacji. DigiSpace zawiera zależności storage, monitoringu, CRM i reCAPTCHA. Zmiana runtime może pozostawić zwykłe strony działające, podczas gdy wychodzące wywołanie API, przesłany obiekt czy zaplanowana komenda zawodzi. Linia bazowa powinna identyfikować właściciela każdej integracji i sposób jej sprawdzenia bez wysyłania prawdziwych danych klientów ani tworzenia zduplikowanych rekordów biznesowych.
Oficjalny przewodnik migracji PHP 8.2–8.3 oddziela nowe funkcje od niekompatybilnych i przestarzałych zachowań. Pokrywa konkretnie ten krok wersji. Aplikacja startująca na wcześniejszym wydaniu PHP potrzebuje też pośrednich przewodników. PHP 8.3 to minimalne ograniczenie tego projektu, a nie uniwersalna rekomendacja dla nowego systemu.
Porównaj trzy podejścia do modernizacji
Aktualizacja w miejscu zachowuje obecną architekturę i koryguje niekompatybilne zależności oraz kod. Ma najmniejszą zmianę produktową, gdy struktura nadal pasuje do biznesu. Jej ograniczenie polega na tym, że może zachować sprzężenie czyniące kolejne funkcje drogimi. Wsparcie wersji i jakość architektury to powiązane, ale nie identyczne zadania.
Stopniowa wymiana wprowadza granicę wokół jednego workflow i zmienia to workflow, podczas gdy reszta pozostaje w użyciu. Wyjaśnienie Strangler Fig Martina Fowlera opisuje to podejście i jego koszt przejściowy. Tymczasowe adaptery i reguły routingu to prawdziwa praca; potrzebują właściciela i ostatecznego usunięcia, a nie stania się kolejną stałą warstwą.
Pełne przepisanie może mieć sens, gdy produkt lub model danych fundamentalnie się zmienia. Tworzy też duży problem akceptacji i migracji: nieudokumentowane zachowanie trzeba odkryć, stare i nowe systemy mogą wymagać równoległego wsparcia, a dane muszą przejść jasno zdefiniowane przełączenie. Żaden z tych obowiązków nie znika dlatego, że zamiennik używa nowszego frameworka.
Zacznij od prawdziwej, widocznej dla użytkownika granicy
Wyszukiwanie usług DigiSpace to użyteczny, ograniczony przykład. Aplikacja przechowuje zarówno skategoryzowane usługi katalogu, jak i wewnętrzne wiersze funkcji powiązane z pakietami cenowymi. Wyszukiwanie powinno zwracać te pierwsze, gdy pasują. Nie powinno reklamować wiersza funkcji, który nie ma publicznej kategorii usługi.
HeaderSearchTest utrwala to rozróżnienie. Poniżej faktyczna metoda testowa, sformatowana w wielu wierszach dla czytelności. Należy do klasy testowej repozytorium, która importuje dwa modele, używa RefreshDatabase i SeedsPublicSite oraz wywołuje seedPublicSite() podczas konfiguracji. To nie jest samodzielny skrypt PHP:
public function test_service_search_lists_matching_categorised_services(): void
{
    $category = ServiceCategory::create(['name' => 'Web', 'slug' => 'web']);
    Service::create([
        'title' => 'Laravel development',
        'slug' => 'laravel-development',
        'status' => 'active',
        'service_category_id' => $category->id,
        'description' => 'Backend'
    ]);
    Service::create([
        'title' => 'Orphaned laravel service',
        'slug' => 'orphan',
        'service_category_id' => null,
        'description' => 'no category'
    ]);

    $this->get('/uk/service-search?search=laravel')
        ->assertOk()
        ->assertSee('Laravel development')
        ->assertDontSee('Orphaned laravel service');
}
Route to /uk/service-search z parametrem query search. To nie /en/services/search. Rekordy używają Service::create(); ten przykład nie wymyśla fabryki, której model nie dostarcza. Te szczegóły decydują, czy czytelnik może odtworzyć zachowanie w tym repozytorium.
Kontroler stosuje zarówno warunek aktywnego statusu, jak i whereHas('serviceCategory'). Test weryfikuje konkretny wyrenderowany wynik dla swoich fixture'ów. Aby udowodnić filtrowanie kategorii niezależnie od wszystkich innych warunków, dodatkowy fixture powinien jawnie oznaczyć osierocony wiersz jako aktywny. Osobne testy powinny pokrywać puste zapytanie, brak dopasowań i zlokalizowaną treść. Pojedynczego przechodzącego przykładu nie wolno opisywać jako pełnego pokrycia wyszukiwania.
Oddziel izolację testów od danych aplikacji
RefreshDatabase może zresetować schemat w rozwiązanej bazie testowej. Nie uruchamiaj przykładu wobec wypełnionej lokalnej bazy aplikacji ani produkcyjnej. Najpierw sprawdź efektywne środowisko, połączenie, hostname i nazwę bazy; zbuforowana konfiguracja Laravela może podważyć założenia o używanych zmiennych środowiskowych.
DigiSpace używa zachowań specyficznych dla MySQL w innych miejscach zapytań publicznej strony, więc zamiana MySQL na SQLite tylko dla uproszczenia uruchomienia może ukryć problemy kompatybilności. Użyj dedykowanej testowej bazy MySQL dla suite repozytorium zależnego od bazy, z fake'ami integracji zewnętrznych tam, gdzie potrzeba. Każdy reset lub czyszczenie powinno być ograniczone do zweryfikowanego celu testowego.
Gdy te wymagania są spełnione, celem skupionego suite jest tests/Feature/HeaderSearchTest.php. Oczekiwany wynik to nie tylko HTTP 200: pasujący tytuł katalogu się pojawia, a osierocony — nie. Nieudana asercja powinna prowadzić z powrotem do routingu, fixture'ów lub warunków zapytania, a nie do natychmiastowego osłabienia testu.
Oddziel zmiany kodu od danych redakcyjnych
Repozytorium może zawierać treść seedów bez bycia właścicielem każdej bieżącej wartości w bazie. Seedery DigiSpace oparte na JSON dla czystej instalacji wstawiają wiersze, podczas gdy StructureTranslationsSeeder dopasowuje istniejące rekordy i wypełnia brakujące tłumaczenia. Istniejące niepuste tłumaczenia redakcyjne wygrywają. Żaden mechanizm nie jest uniwersalnym publikatorem dla zmienionego artykułu.
To rozróżnienie wyjaśnia, dlaczego wdrożenie zaktualizowanego pliku JSON może pozostawić żywą stronę niezmienioną. I odwrotnie, ponowne uruchomienie seederów czystej instalacji na wypełnionej bazie może zawieść lub wpłynąć na niepowiązany stan. Ukierunkowana zmiana treści powinna identyfikować rekordy po stabilnym slug, ograniczać zmieniane pola, zachowywać autorów i obrazy, gdy nie są w zakresie, oraz wcześniej zrobić odwracalną migawkę.
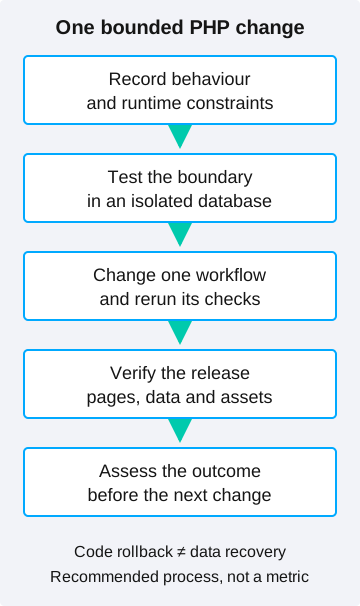
Dla modernizacji ta sama zasada dotyczy migracji: wiedz, którymi danymi zmiana jest właścicielem. Unikaj łączenia aktualizacji runtime, przeprojektowania schematu i szerokiej wymiany treści w jednym wydaniu. Gdy wynik jest błędny, mniejsze zmiany pozwalają zidentyfikować, która operacja wprowadziła różnicę.
Sprawdzaj wyniki wdrożenia, nie tylko wyniki buildu
Hook wdrożeniowy DigiSpace uruchamia migracje, publikuje zasoby Livewire, przebudowuje cache konfiguracji i widoków oraz generuje sitemap. To konkretne zachowanie repozytorium. Nie jest to dowód, że każdą migrację da się cofnąć ani że przywrócenie poprzedniego katalogu kodu przywraca też zawartość bazy danych.
Zdefiniuj rollback kodu i odtwarzanie danych osobno. Poprzednie wydanie może już nie rozumieć zmienionego schematu. Odtworzenie bazy może odrzucić edycje wykonane po backupie. Dla ewolucji schematu preferuj kompatybilne, etapowe zmiany, gdy to możliwe; dla treści — zachowuj migawkę na poziomie pól i sprawdzaj intervenujące edycje przed jej przywróceniem.
Zasoby publiczne wymagają niezależnej kontroli. Poprawny tag og:image może nadal wskazywać na brakujący plik. Zweryfikuj wynik HTTP, typ treści, wymiary obrazu i widoczny obraz zamiast traktować asercję metadanych jako kompletny test podglądu społecznościowego. Dla stron zlokalizowanych sprawdzaj też linki canonical i faktyczne cele nawigacji obok przetłumaczonych nagłówków.
Co to dowodzi i kiedy tego nie kopiować
Repozytorium daje dowód ukierunkowanego testu wyszukiwania, jawnych ograniczeń zapytań publicznych oraz osobnych mechanizmów wdrożenia i tłumaczeń. Nie dostarcza zmierzonego zmniejszenia awarii ani kosztu rozwoju przed i po. Obroniona korzyść jest węższa: ważne zachowania można nazwać i sprawdzić zamiast ponownie odkrywać je ręcznie po każdej zmianie.
Nie zamieniaj stopniowej modernizacji w niekończące się łatanie, gdy produkt bazowy jest wymieniany. Nie wprowadzaj warstwy serwisów wokół każdej krótkiej funkcji bez konkretnej granicy do ochrony. I nie zaczynaj szerokiej aktualizacji, gdy backupy, widoczność runtime i izolowane środowisko weryfikacji wciąż nie istnieją.
Po ograniczoną współpracę zobacz development i modernizację PHP. Zacznij od jednego workflow, jego oczekiwanego wyniku i warunków awarii. To tworzy użyteczne pierwsze wydanie i lepszą podstawę do decyzji, czy następnym krokiem jest utrzymanie, wydzielenie czy wymiana.
Kategorie
Najnowsze wpisy
Archiwum